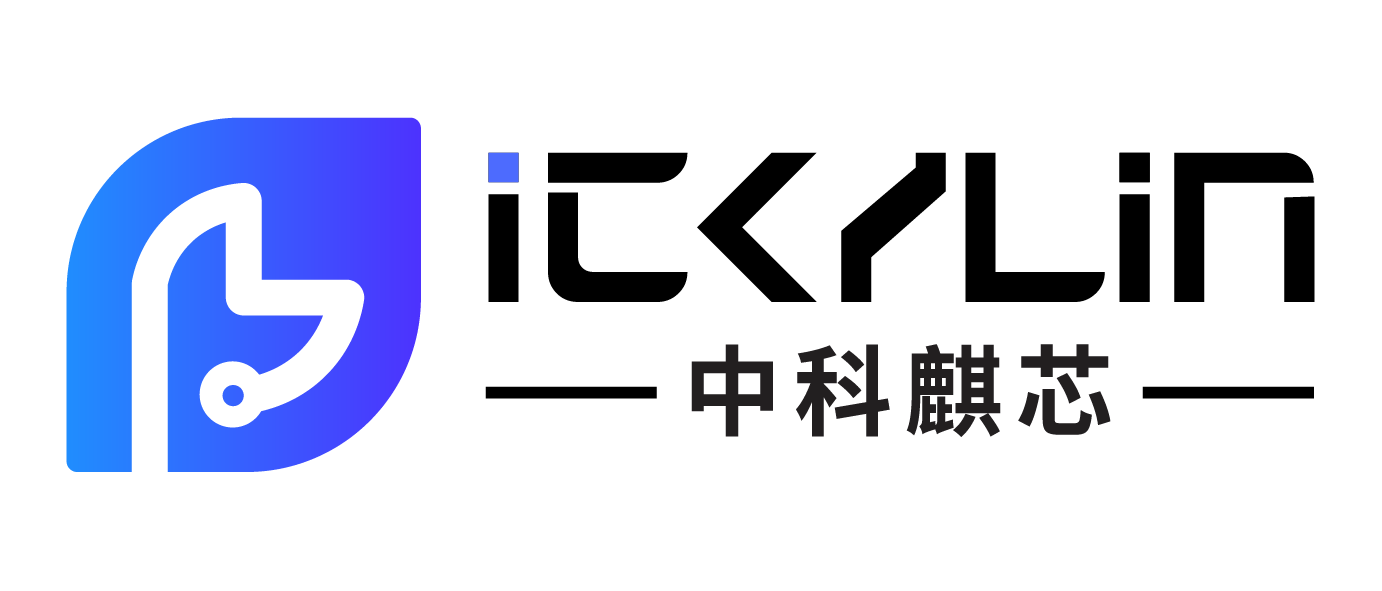
GPU 资源与运行趋势
采集节点状态及 GPU 利用率、显存、温度与功耗,监测离线和指标越限,并回看异常前后的变化。
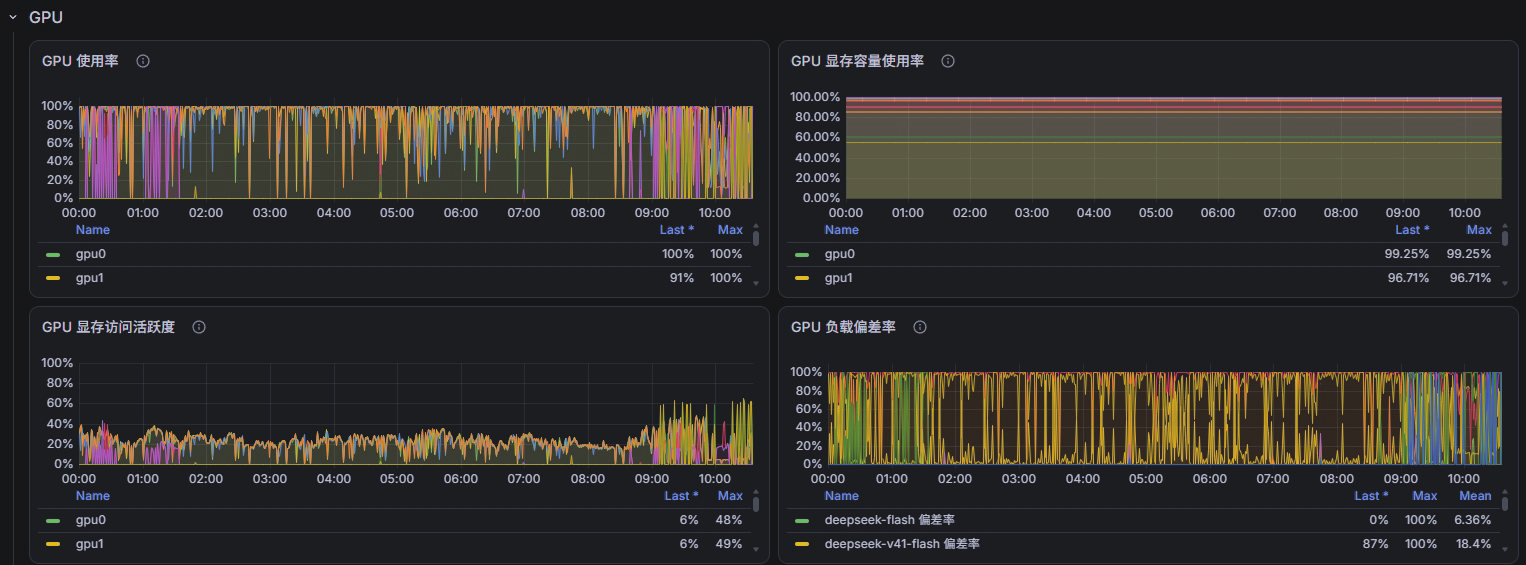
衔接模型适配、部署验证与持续运维,配套 GPU 与模型服务监控
以算力供给与模型服务、监控及分发、AI 管理及应用三层架构,衔接 GPU 采购与租赁、模型工程、GPU 运维、Token 管理和研发流程。按需求梳理、资源评估、方案建议、部署验证、持续运维五阶段交付。
工程交付实践已为 10+ 家客户提供落地服务,涵盖模型私有部署、应用联调与上线运维。
左右滑动查看完整图示
从需求与资源评估开始,明确实施范围,完成部署验证,再进入持续运维。
梳理任务、资料与保密要求。
评估模型、显存、并发与现有环境。
明确配置、接入方式与实施范围。
验证模型与应用接入及负载。
持续监控响应,升级与优化。
GPU 健康度监控作为 FDE 的配套能力,将节点、GPU 与模型服务的运行信息集中呈现,帮助工程师发现异常、回看趋势并定位问题。具体监控范围结合部署环境与实施需求确定。
采集节点状态及 GPU 利用率、显存、温度与功耗,监测离线和指标越限,并回看异常前后的变化。
结合模型服务探活、HTTP 状态与并发请求,观察服务是否可用、是否出现排队。
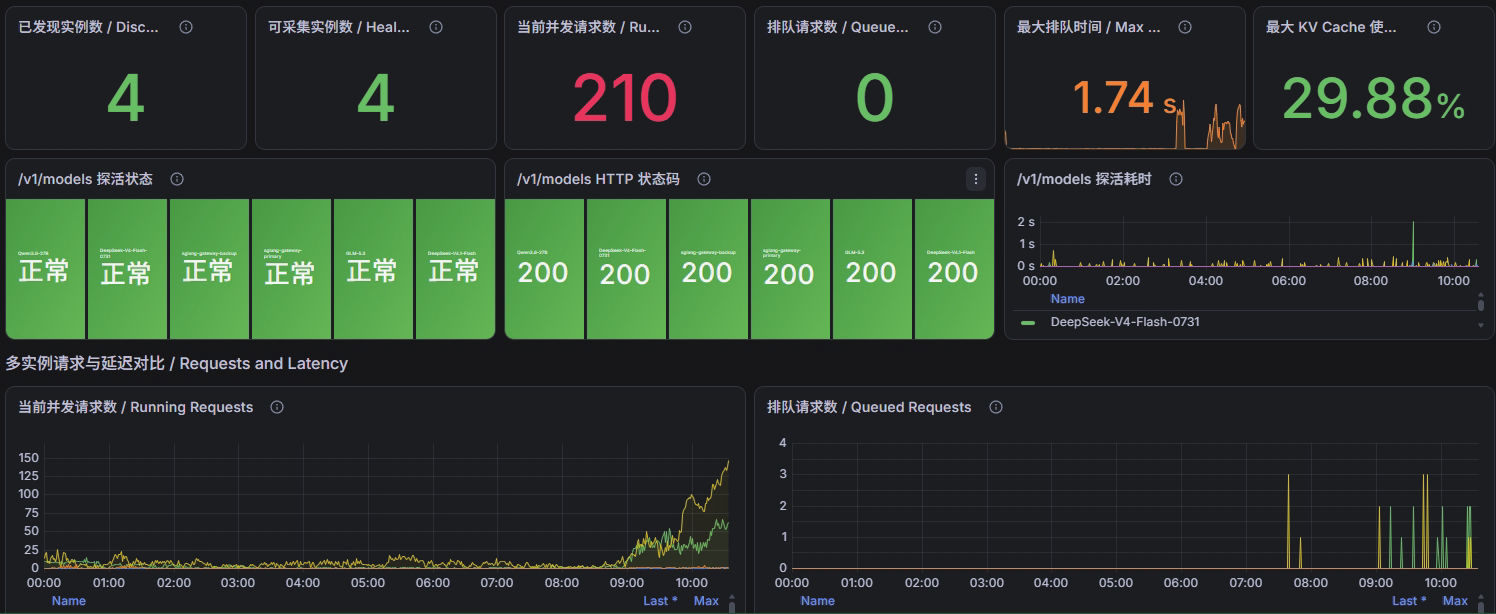
对照请求率、端到端延迟、排队时间与首 Token 延迟,回看负载变化时的服务表现。
结合现有算力、模型与应用,沟通部署范围、运行监控和后续运维需求。